Hay una escena que se repite en casi todas las casas: pones una película, el volumen está a un nivel cómodo para la música, pero los actores hablan tan bajito que no entiendes nada. Lo subes. A los dos minutos cae una explosión, o entra la publicidad a todo trapo, y vuelves al mando a bajar el sonido. Y así toda la noche.
La culpa no es del televisor, o al menos no solo. Las bandas sonoras de cine están mezcladas para salas con decenas de altavoces y un sistema calibrado. Cuando esa mezcla llega a casa y se adapta a un estéreo de dos altavoces pequeños, el diálogo —que en un 5.1 va por el canal central— acaba escondido entre la música y los efectos. En un televisor viejo, con conos que no bajaban bien y una respuesta irregular en las frecuencias medias, el resultado puede ser dramático.
La música es un buen sitio para hablar de esto
Quien haya grabado alguna vez sabe que mezclar voz y música no es cuestión de subir el fader. Es cuestión de espacio y de frecuencias. En un home studio se resuelve con una buena ecualización y un compresor de cadena lateral. En una película, el problema es el mismo, pero a lo grande.
Para eso nació el Algoritmo Zainder, un trabajo publicado con DOI en Zenodo, una de esas ideas que uno tiene mientras pelea con el mando a distancia y luego se empeña en documentar con ecuaciones.
Qué hace distinto
Lo habitual es aplicar ecualización y compresión sobre la mezcla entera. Rápido, pero con un efecto secundario conocido: si aprietas la voz, aprietas también la música, y aparece el bombeo. Zainder cambia el orden. Primero separa la voz del fondo; después trata cada parte por su lado, y solo al final las junta, con el fondo retirándose cuando alguien habla. Todo dentro de un único procesado de FFmpeg y con salida estéreo.
- Separación de voz y fondo.
- Paso alto a 120 Hz para no mandar al altavoz energía que no puede reproducir.
- Compresión asimétrica: la voz aprieta más que el fondo, con valores de 2,3:1 y 1,7:1 en el ajuste por defecto.
- Ecualización de inteligibilidad solo en la voz: se recorta un poco en 350 Hz y se suben las zonas donde viven las consonantes.
- De-esser y exciter como filtros de presencia, sin inventar armónicos.
- Ducking por cadena lateral, que es donde se gana la pelea.
- Normalización y limitador de picos al final de la cadena.
Todo se maneja con un único mando de intensidad, de 0 a 1. Eso permite graduar cuánto se modifica la mezcla: hay quien solo quiere un empujoncito y quien necesita que el diálogo se imponga.
Con nombres y apellidos
Hay un detalle que me gusta de este trabajo y es que no vende humo. El autor reconoce que las pistas 5.1, 6.1 y 7.1 permiten separar la voz del canal central de verdad, pero que en estéreo solo se consigue un énfasis espectral sobre la propia mezcla. Lo dice tal cual: solo una de las rutas separa de verdad. El resto son aproximaciones honestas.
También queda claro lo que falta. La cadena está probada con señales sintéticas, se ejecuta sin error y respeta el techo de picos, pero no hay todavía pruebas con películas reales ni con oyentes. El protocolo para hacerlo está escrito: métricas como STOI y SII, medidas de sonoridad según BS.1770 y pruebas subjetivas con MUSHRA. Falta ponerlo delante de orejas de verdad.
Dónde se puede probar
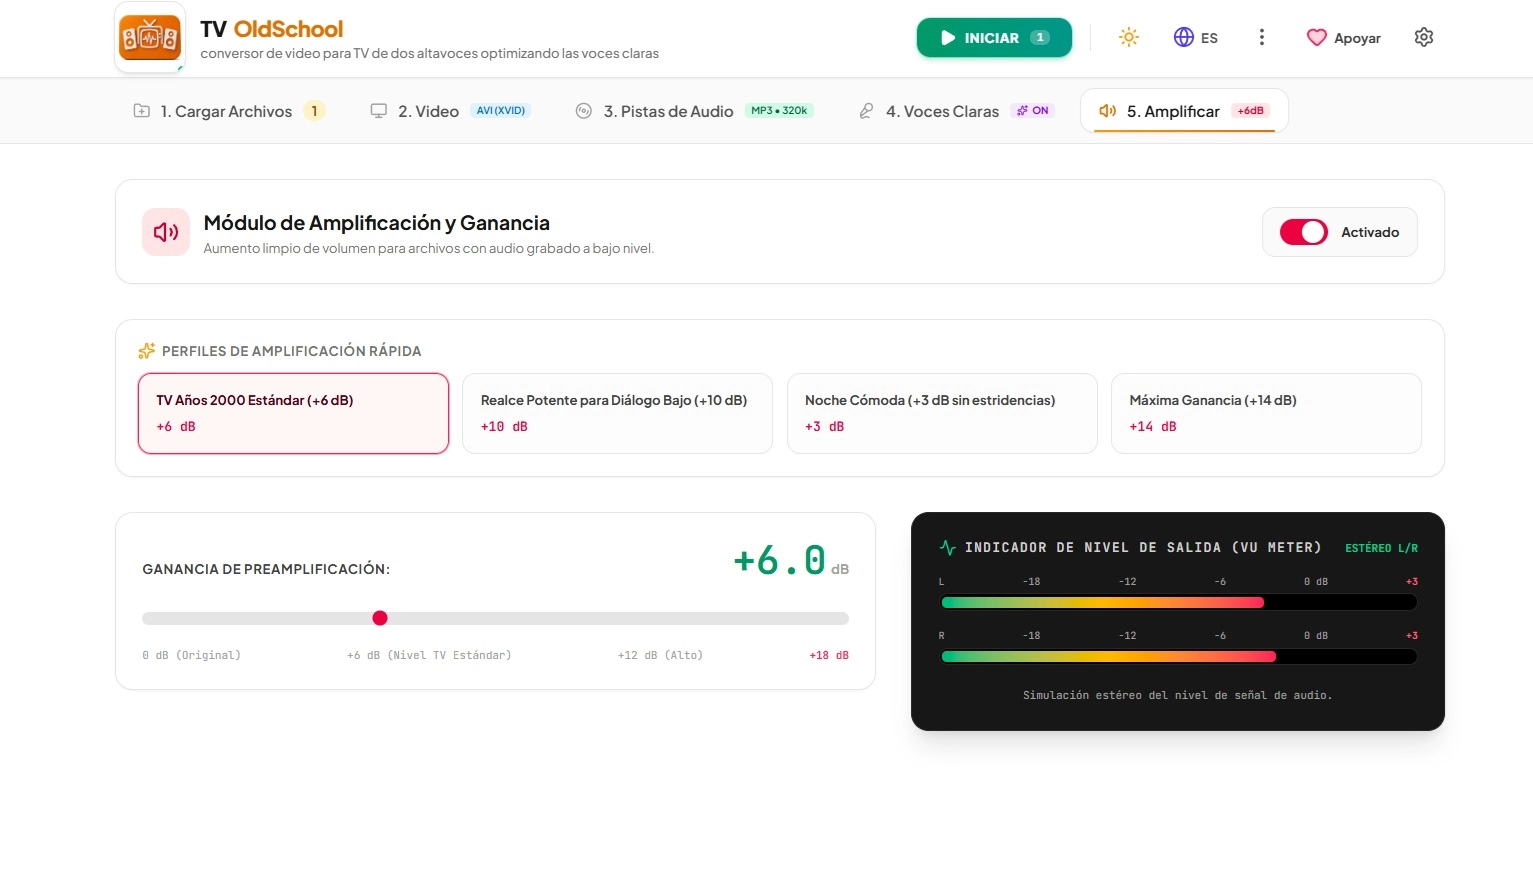
La implementación práctica se llama TV Old School, una aplicación que procesa el audio de un archivo de vídeo y devuelve una pista estéreo. No funciona con televisión en directo, es procesado en diferido. El código está disponible en SourceForge y en GitHub.
En el fondo, es una idea muy de rock: no hace falta tocar más fuerte para que la letra se entienda, hay que saber qué se está tocando y qué se está cantando. Y darle sitio a cada cosa. Si quieres leer el trabajo completo, con la formulación matemática y los parámetros, está publicado en https://doi.org/10.5281/zenodo.24437921.